

idea notebook 与 lab API
This content is not available in your language yet.
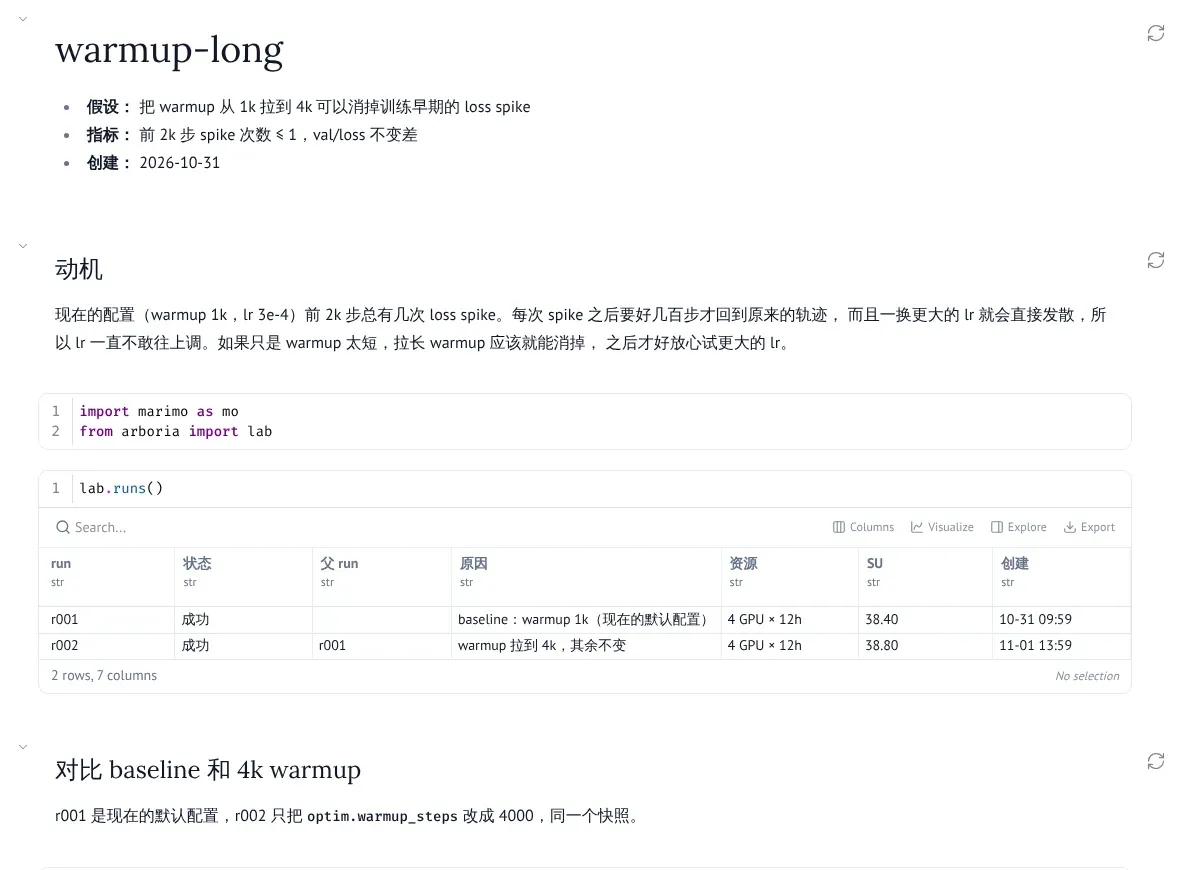
每个 idea 有一个 marimo notebook。你在里面整理思路、发起实验、分析结果,就像普通 notebook;Claude 能读,不能改,它的活来自你在 notebook 里留下的待办。
arb idea new(或arb idea plant、lab.fork)同时创建.arboria/notebooks/<idea>.py,worktree 里的notebook.py是指向它的符号链接。模板只在新建时写入,以后不会改你的 notebook。notebook.py写进了.git/info/exclude,快照永远不包含它:改 notebook 不会让快照变化,合并时也不会冲突。仓库里本来就有被跟踪的notebook.py时,arb 不覆盖它,只提示你直接打开.arboria/notebooks/<idea>.py。- 关闭 idea 时只删掉符号链接,notebook 本身保留;备份仓库每次提交都带上
notebooks/*.py。 arb install-claude禁止 Claude 用 Edit/Write/MultiEdit/NotebookEdit 改**/notebook.py和.arboria/notebooks/**,读不受限。- 旧的 idea 没有 notebook(或者你删了它):
arb idea notebook [NAME]补建;已经有了就什么都不改。
lab API
Section titled “lab API”from arboria import lab
r = lab.run(reason="warmup 1k", gpus=4, time="12h", set={"lr": 3e-4}) # 只生成审核单r # 一行状态 + 一行提示;审核单折叠在下面r2 = lab.run(reason="lr 小一点", from_=r, set={"lr": 1e-4}) # 同一快照,只改参数lab.runs() # 当前 idea 的 run 一览;lab.runs(raw=True) 是账本里的所有列lab.get("r001") # 按 id 取一个 run 句柄r2.metrics(["val/loss"]) # wandb 曲线(需要 wandb)lab.compare(["r001", "r002"], "val/loss") # 长表lab.plot(["r001", "r002"], "val/loss") # 画在一张图上,一个 run 一条线lab.diff("r001", "r002") # 两个 run 哪里不同lab.spend() # 各 idea 花了多少 SU / GPU 时;lab.spend(".") 逐个 runlab.commands() # 内置的和 Claude 写的所有命令lab.todo("把 eval 改成每 500 步一次") # 给 Claude 留待办,显示成一行;lab.todos() 列出待办lab.fork("lr-warmup-cosine", from_=r, hypothesis="...", metric="...") # 从 r 的快照分出新 idealab.conf("prelim") # 改置信度;lab.metric("...") 改指标lab.prune("loss 不降") # = arb idea drop,理由记成你的笔记lab.run(reason, from_=None, set=None, gpus=None, time=None, partition=None, nodes=None, machine=None, command=None)和arb submit完全一样:只在本地生成快照(或复用from_的快照)和审核单,绝不批准。命令默认取arboria.toml的[run] command,set按[run] override_style接在后面。- 重复执行 cell 是安全的:同一个 idea 里已经有审核单哈希相同、且没被拒绝/取消/失败的 run 时,直接返回它。
- 有意重复跑(例如看种子方差):
lab.run(..., repeat=True)每次都建一个新 run,审核单上写“⚠ 重复运行”。注意带repeat=True的 cell 每执行一次就多一个待批准的 run。 lab里没有任何批准函数。待办、置信度、指标、prune记的是你的记录,在 Claude Code 里调用会被拒绝。它们在 cell 重跑时不会重复:值没变就什么都不写,一模一样的未完成待办直接返回已有的那个。
几条常用的分析是现成的,不花 token,也不用等 Claude:
lab.plot(runs, key, log=False):一个 wandb 指标随 step 的曲线,一个 run 一条线,图例一个 run 一项;没有 wandb 数据的 run 写在图下面。.data是长表。不用新的依赖,图是内联 SVG。lab.diff(a, b):只列不同的地方:命令和--set、资源、代码(两个快照之间的git diff --stat,只读,不碰你的分支和工作区)、拉回来的 config 逐个键。lab.spend(idea=None):账本里各 idea 用了多少 SU 和 GPU 时,对照arboria.toml的预算,另有待批准的 run 最多还要多少;lab.spend("exp1")或lab.spend(".")(当前 idea)逐个 run。
更多的分析是你的命令库,见 自定义命令。
当前 idea 怎么确定
Section titled “当前 idea 怎么确定”按顺序:lab.use("<idea>") 手动指定 → 调用者的 __file__(marimo 里就是 notebook 文件)→ 正在运行的 marimo app → 当前目录所在的 idea worktree。都不行就报错,提示你 lab.use(...)。
Run 句柄
Section titled “Run 句柄”.id、.status()、.card()、.jobs()、.wandb_url、.metrics(keys)、.local_out(拉回来的 ARBORIA_OUT)、.config(解析后的 config)。
在 notebook 里,一个 run 显示成两行:第一行是 r003 · 待批准 · 原因 · 来自 r002;第二行随状态变化:待批准时是 arb approve r003,运行中是已运行多久(分段时是第几段),成功时是用时、SU 和 wandb 链接,失败时是失败原因(arb watch 记下的那一行日志)。审核单、作业表和 run 总结折叠在下面。
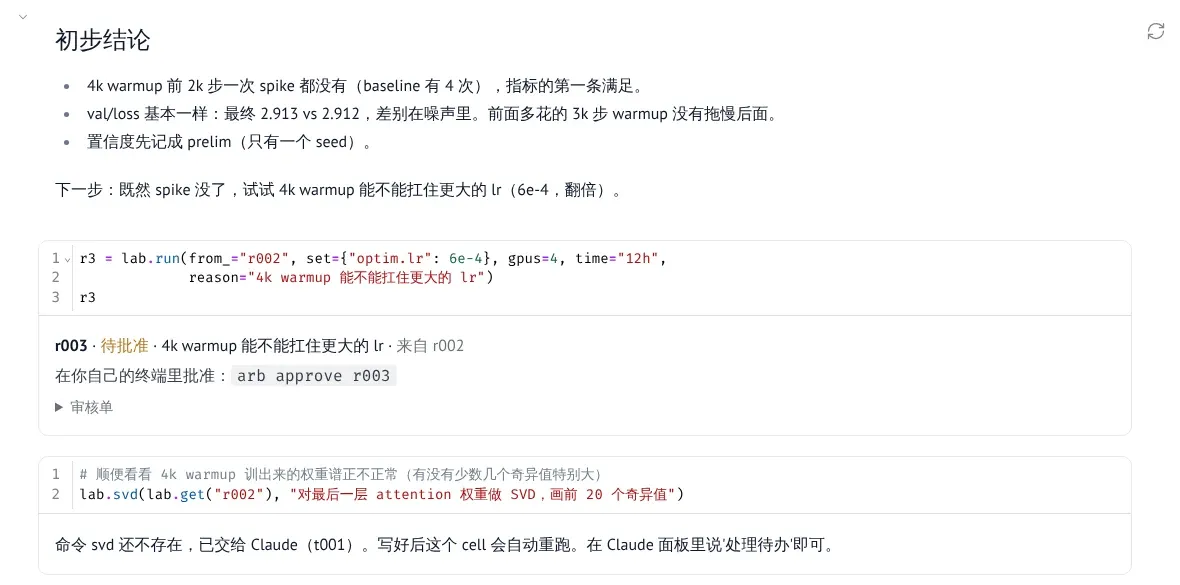
lab.runs() 的列
Section titled “lab.runs() 的列”run、状态、父 run、原因、资源(4 GPU × 12h)、SU(结束后是实际花费,之前是 ≤ 估计上限)、创建时间。有 pandas 时是 DataFrame,否则是 dict 的列表。要账本里的全部列用 lab.runs(raw=True)。
- 你在 notebook 里写
lab.todo("...");SessionStart hook 在当前 idea 的状态里列出未完成的待办,Claude 据此干活。 - 在 notebook 里,
lab.todo("...")显示成一行:已交给 Claude(t001):<待办>;cell 重跑时找到同一个未完成的待办是已在待办里(t001):<待办>;做完的是已完成(t001):<待办> → <结果>。 lab.todos(include_closed=False)是一行一个待办的简短列表:t001 · 等 Claude · <待办> · 3 分钟前(状态:等 Claude、已完成、已放弃)。文字一律转义,太长的截短,悬停看全文。- 返回值照旧能当数据用:
t.id、t.text、t.status、t.result、t.existed(是不是复用的),t["id"]也行,t.data是完整的 dict;lab.todos()可以遍历、取下标,.data是 dict 的列表(要 DataFrame 就pd.DataFrame(lab.todos().data))。 - 命令行:
arb todo list [--all] [--json]在 idea worktree 里列这个 idea 的待办,在主 worktree 里列所有 open idea 的。 - Claude 做完后
arb todo done tNNN --result "..."(≤600 字符);不做了arb todo drop tNNN [--reason "..."]。 arb note只由你写;Claude 的结论写进待办结果或arb run summary RUN "..."。